在在线旅游行业,数据就是生命线。从用户搜索、比价、下单到行程管理、客服反馈,每天产生的数据量高达TB级别,且这些数据需要在高并发场景下实时处理,以支撑个性化推荐、动态定价、风险控制等核心业务。携程作为行业领军者,其大数据应用架构经历了从简单到复杂、从集中到分布、从批处理到流批一体的涅槃式演进。本文将深入剖析携程如何应对每天TB级数据和高并发的双重挑战,揭示其架构设计的关键决策与实践经验。
一、数据规模与高并发挑战
携程平台日活跃用户数千万,高峰时段每秒请求数可达数十万。每一次用户行为都会产生日志数据,加上订单、库存、支付等业务数据,每日新增数据量稳定在TB级以上。这些数据不仅体量大,而且具有高并发写入、实时性要求高、格式多样等特点。例如,机票搜索接口在旺季每秒需处理数万次查询,同时要实时更新价格和库存;用户行为日志需要秒级可见以实现实时推荐;风控系统需要在毫秒级内完成规则匹配和模型预测。传统的单一数据库和批处理架构显然无法胜任,携程必须构建一套高可用、高并发、可扩展的大数据处理架构。
二、架构演进:从Lambda到Kappa的涅槃
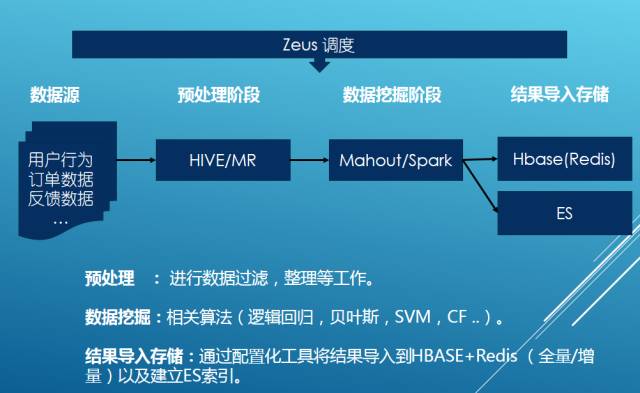
携程早期采用典型的Lambda架构,即批处理层(Hadoop)与速处理层(Storm)并存,分别处理历史全量数据和实时增量数据,再通过服务层合并结果。这种架构虽然满足了基本需求,但存在代码冗余、逻辑不一致、运维复杂等问题。随着实时性要求提升,携程逐步向Kappa架构(以流处理为核心)转型,并引入Flume、Kafka作为数据管道,Spark Streaming和Flink作为流计算引擎,HBase、Redis作为在线存储。涅槃的关键在于:统一了批流处理的编程模型,降低了开发运维成本;通过Kafka实现数据回放,保证了流处理的准确性;采用分层存储(HDFS+Alluxio+HBase)平衡了成本与性能。
三、高并发下的数据处理关键技术
- 数据采集与分流:使用Flume Agent集群采集应用日志,通过Kafka进行削峰填谷,按主题分流至不同计算集群。高峰期Kafka集群可承载每秒百万级消息写入。
- 实时计算引擎:基于Flink构建实时ETL和复杂事件处理管道,实现Exactly-Once语义,确保数据不重不漏。例如,实时风控规则在Flink中运行,延迟控制在100ms以内。
- 存储优化:对于高并发点查场景,采用HBase+Redis两级缓存;对于历史数据分析,使用HDFS+Parquet列式存储;引入Alluxio作为内存加速层,提升跨集群访问效率。
- 资源隔离与弹性伸缩:通过YARN和Kubernetes实现计算资源的分池管理,根据业务优先级动态调整;利用弹性伸缩应对流量洪峰,例如在大促期间自动扩容Flink TaskManager。
- 数据治理与质量:建立元数据中心和血缘追踪,通过数据质量监控平台实时检测异常,确保高并发下数据的一致性。
四、架构涅槃后的业务价值
新架构上线后,携程大数据处理能力显著提升:实时数据延迟从分钟级降至秒级,推荐系统CTR提升15%,风控拦截效率提高3倍;资源利用率提高40%,运维成本降低30%。更重要的是,架构的弹性扩展能力支撑了业务的高速增长,为国际化和大促提供了坚实基座。
五、未来展望
随着5G和AI的普及,数据量将持续爆发。携程正探索湖仓一体、Serverless流计算等新技术,进一步简化架构、降低成本。涅槃没有终点,唯有持续演进,方能驾驭数据洪流。